第一次把大模型装进一台小机器
 RX
10月份参加了第二届CIE比赛,去年也参加了,但是因为考试遗憾没有去线下,今年又一次选择了进迭时空,做的是赛题二:简单说就是在一台很小的机器上把一个大模型跑起来,还要想办法让它跑得快一点,也就是所谓本地部署,带优化。机器是进迭时空的K1笔记本,8核1.6GHz、8GB内存,平时就放在桌上,接电接网线就能用。代码和脚本已经开源,放在GitHub 仓库。
以前我用大模型都是打开网页、打一句话、等它回我,从没想过它到底待在哪儿。这次反过来:它得整个待在这台机器里,不联网,也不找别人帮忙。
半个月下来,最意外的一件事是——最后让速度翻倍的,不是换硬件、不是改参数,也不是换了个更厉害的运行时,只是把模型文件重新做了一份。什么都没动,换掉一个文件而已。
一、10月28日:先把机器弄成能用的
机器之前装成Ubuntu了。看着能用,但装不上厂商那套加速组件,内核里也缺几样驱动。当天晚上就刷回了厂商的Bianbu 2.3.5,2.09GB的镜像,刷完确认内存7.7GiB可用、指令集里那个加速扩展确实在位,才算真正开始。
第一步不是优化,是先让它出字。先用很小的0.6B模型试通,再上2B,第一次看见终端里一行一行往外蹦中文的时候还挺高兴。然后跑了一轮基准,把「读进去」和「往外吐」分开记:
| 模型 | 读进去(512字) | 往外吐(128字) |
|---|---|---|
| 2B | 10.84字/秒 | 2.84字/秒 |
| 4B | 3.80字/秒 | 1.32字/秒 |
数字很朴素,但意思很直接:让它把一篇长东西读完,比让它一个字一个字说话快得多。(表里的「字」是模型自己的计数单位,比一个汉字略多一点,看个比例就行。)一开始我以为「慢」就是机器弱,8GB内存、1.6GHz,好像也没什么好抱怨的。
顺手还撞见一个硬规矩:线程数必须显式写4。不写的话,命令行版本直接崩掉,报错说线程数超过了后端登记的核心数;基准工具不崩,但吐字速度掉70%。这条后来写进了所有脚本,也写进了文档的「重要约束」里。
二、慢,但一开始怪错了人
当时日志里有一行很扎眼:某个设备节点打不开,看起来像是加速没吃上。于是我列了三条候选原因,一条一条去试。
第一条是那块片上高速内存没生效。为了验证它,得自己编译一份打过补丁的运行时。在K1本机上编了两次都失败——系统自带GCC 13.2缺一个半精度向量头文件,官方其实本来就用x86交叉编译。换成交叉工具链之后,中间又踩了三个坑:某个编译开关在配置文件里漏声明了、源码包缺网页产物导致链接失败、还有最隐蔽的一个——交叉编出来的程序没设库路径,运行时悄悄加载了系统自带的旧库,表现成「我明明改了却还在报旧路径」。
最后补丁上板成功,日志里明确打出「512KB真实片上内存,非模拟」。然后测性能:没有变化。20.07对20.36,差1.4%,在误差里。
第二条是运行时太旧。编了新版0.2.3,结果在K1上反而比0.1.1低23%到75%;同一份新文件放上去,只快了5.6%。第三条线程数前面已经否掉了。
| 现象 | 一开始以为 | 实际是 |
|---|---|---|
| 加速没吃上 | 片上内存没打开 | 补丁修好、真实内存分配到手,性能一点没变 |
| 版本太老 | 编个新版会更快 | 新版更慢,收益只在0.1.1这条后端上成立 |
| 整机突然慢一半 | 降频了 / 供电不足 | 是我自己为测补丁把设备节点权限改成666后忘了改回来;半可用比完全不可用还慢38% |
| 16K那组跑了三次才出 | 机器不稳 | 板子上还有别人起的基准任务,清理进程时把我的也一起杀了 |
| 后台任务「温度只有30度」 | 负载很轻 | SSH一断,后台进程被挂断信号杀掉了,根本没在跑 |
最后一条当时骗了我挺久:以为测到了「轻负载低温」,其实是进程早死了。后来长任务一律挂在常驻终端里跑。
这三次否证挺值钱的。它意味着原因不在硬件、不在运行时、不在线程数,收敛到模型文件本身。
三、文件名字叫Q4_0,里面却不是
官方给的模型文件叫Q4_0,听上去是整整齐齐一种压缩格式。实际打开看张量类型,里面混着五六种:Q5_K、Q6_K、Q8_0、Q4_1……这是发布方为了保精度做的混合精度,本身没毛病。
毛病在K1这台机器上:它那个加速单元只认一小串固定类型,名单里的走定点快路径,名单外的整体退回通用计算。**这不是「文件大一点所以慢一点」的连续变化,是个二元开关。**而且名单外那批里,有18个属于每层都要算的张量,读每个字都绕不开。
后来发现一个特别土但好用的判据:不用等基准跑完,看30秒温度就行。4核满载走加速路径时芯片能上到55℃以上,走通用路径时CPU照样占390%,温度只有31~32℃——忙是忙,但忙的是慢的那条路。
各格式的实测结果摆出来,二元性就很直白了。下面是4B模型在同一条命令下的读数:
| 格式 | 体积 | 读进去(512字) | 结果 |
|---|---|---|---|
| Q4_0(自产) | 2.50G | 8.10字/秒 | 命中快路径 |
| Q4_1(自产) | 略大 | 8.11字/秒 | 同样命中,但白胖一点 |
| Q4_K_M(自产) | 2.66G | 4.37字/秒 | 只有一半 |
| Q5_K_M(自产) | 3.08G | 50分钟没跑完 | 同一任务Q4_K_M只要10.7分钟 |
| Q3_K_M(自产) | 2.30G | 20分钟中断 | 文档说支持,实测没命中 |
顺带说一句,那个温度判据后来被我自己收窄了:查硬件传感器时发现我读的第一个温度节点根本是电池电量计,恒定28.9℃;再测两种命中格式,满载峰值都是53℃。所以「看温度分辨快慢」只在特定窗口成立,不是万能尺。写进文档之前先看归档数据的采样跨度,这个教训比结论本身更有用。
四、那就自己做一份
既然问题是文件里混了不该有的类型,解法就变成体力活:从官方原始权重开始,自己做一份干净的。
五步,全在另一台x86电脑上做,因为4B转一次峰值要10~12GB内存,K1上必然爆:
下载原始权重(13GB) → 转成中间格式 → 剥掉运行时不支持的多余层 → 压成Q4_0 → 拷到K1上核验中间两个小坑值得记:剥离那一步2B是335个张量变320个,4B是441变426,还得顺手改三个元数据键;量化器用系统自带的0.1.1会直接报「列数不能被32整除」——模型里有16列的小张量,必须自己编一个v0.2.3的量化器才吃得下。转换本身倒很快,2B十几秒、4B46秒,量化47秒和99秒。
校验只要三项:层数对、多余层为0、所有矩阵权重都是同一种类型。后来把这三条做成了脚本里的一道门禁,不通过就不让往下走。拿它去扫两个官方文件,2B的204个权重里有54个没命中,4B的272个里有72个;自产的两份都是0。
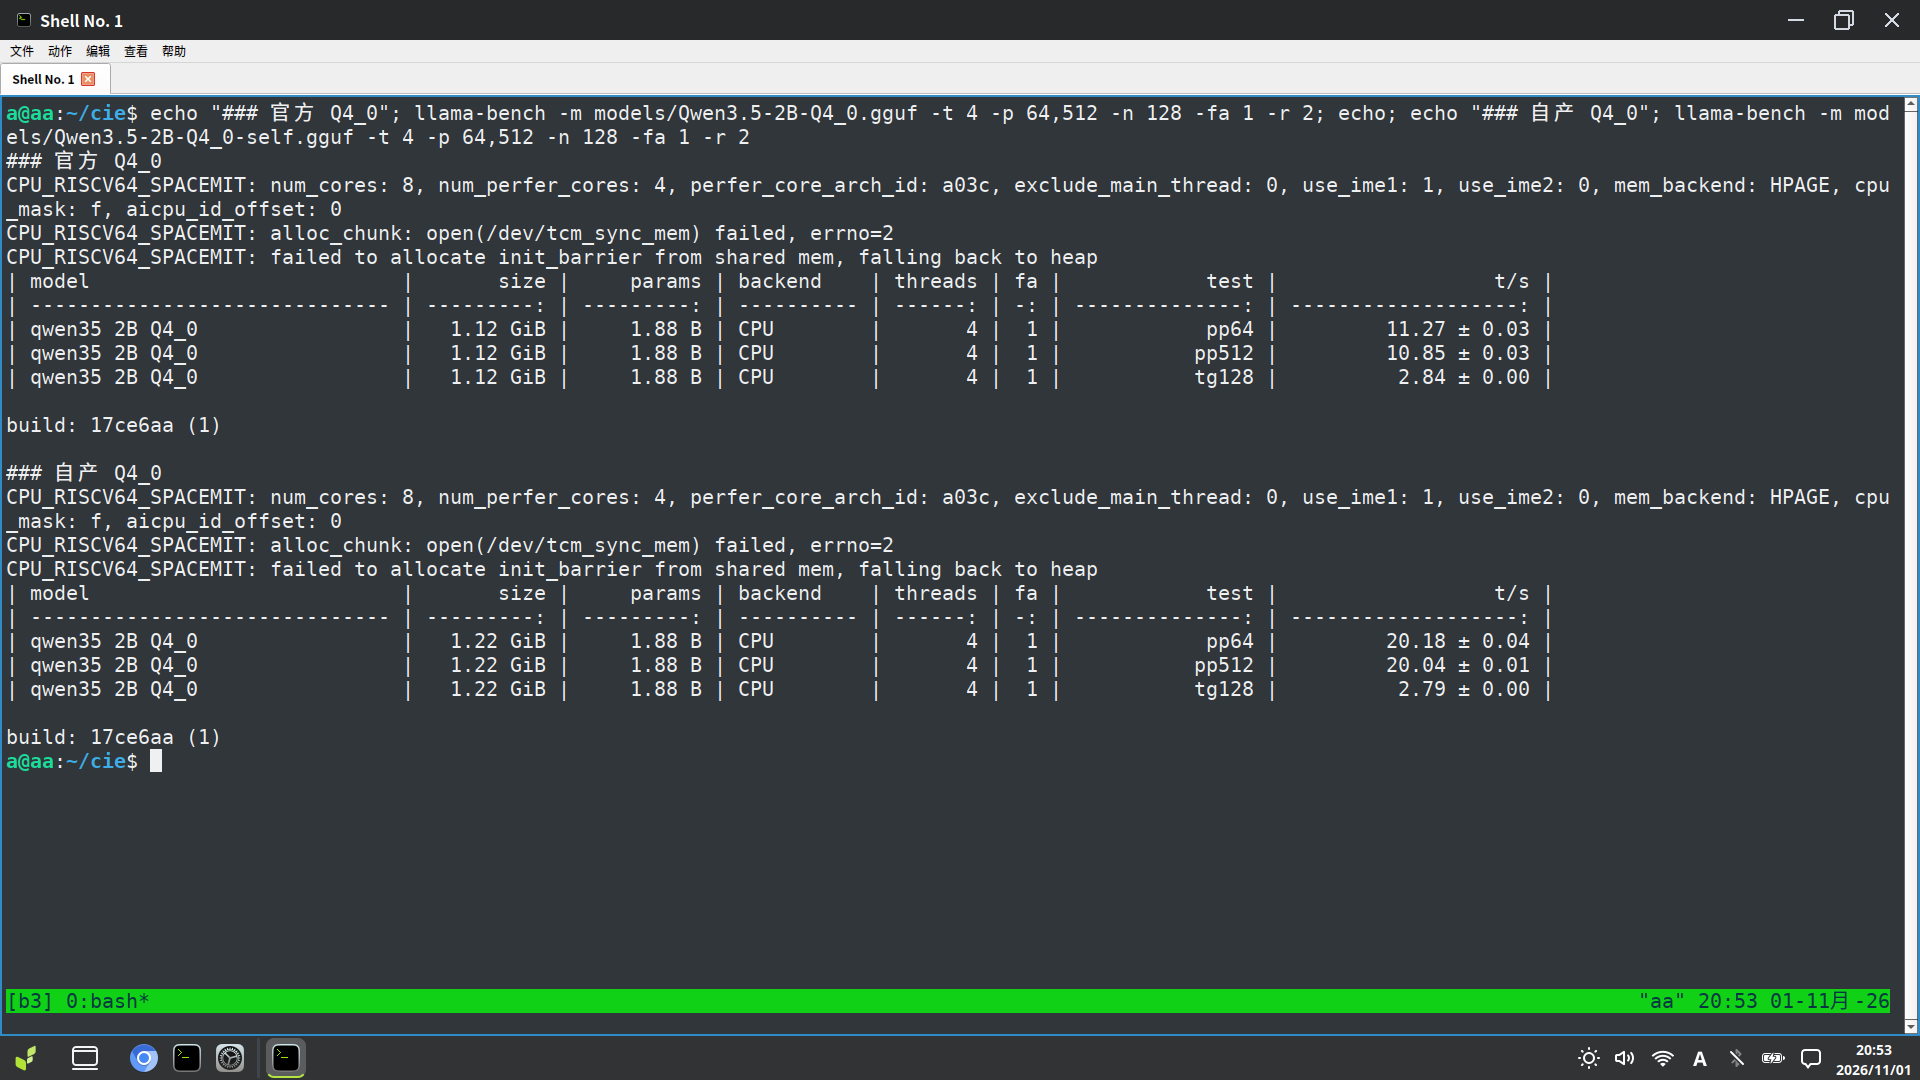
换上去那一轮,同一台机器、同一条命令、同一个提示词:
| 指标 | 官方文件 | 自产文件 | 变化 |
|---|---|---|---|
| 2B 读512字 | 10.84 | 20.36 | +87.8% |
| 2B 吐128字 | 2.84 | 2.80 | −1.4% |
| 4B 读512字 | 3.80 | 8.10 | +113.2% |
| 4B 吐128字 | 1.32 | 1.43 | +8.3% |
模型越大,赚得越多;但吐字几乎没动。这一点后来反复被验证,也成了整个项目最清楚的边界:我们改的是「读」,不是「说」。
还多做了一步交叉验证:换一个完全不相干的开源运行时(不带厂商加速),同一份自产文件依然快59%~71%。两级收益能乘起来对上账:8.67 × 1.250 × 1.878 ≈ 20.36。这才敢说这不是某个后端的特例,而是「混合精度在向量路径上本来就吃亏」。
五、那些等不完的下午
这个项目里最不体面的部分,是等。
为了测「输入特别长时会慢成什么样」,得先让模型把那么长的上下文老老实实填一遍。2B填32K,自产那份跑了70.3分钟,官方那份93.1分钟;4B填32K,198.8分钟,三个多小时里屏幕几乎不动,最后读进去只有1.74字/秒、吐字0.28字/秒,折算下来问一句长问题光等第一个字就要约3.2小时。
长输入的第一次出字延迟也实测过:2B输1200字要等62秒,4B输1208字要等158.5秒。短输入倒是1~2秒。所以结论不是「能用」或「不能用」,而是「4B只适合短问长答,长文档得用2B」。
16K那组更折腾,跑了三次才成。前两次都是跑到一半被板子上另外起的验证任务杀掉,第三次趁空闲窗口才跑完,72分钟。后来养成习惯:跑长任务前先看一眼有没有别人的基准在跑,看到进程名也不能默认是自己的。
还有一件事改了两次。一开始我按「内存=权重+固定缓冲」估上限,后来实测发现缓冲是随上下文长度线性长的,1.47e-5 GiB/字;再后来补了4B的数据,发现它的系数是2B的2.45倍,还跟模型宽度有关。于是4B的实际上限从原先按缓存单算的160K,一路改到约54K。两次都是被自己的外推骗了,第二次尤其:拿小模型的规律去套大模型,会低估0.7GiB。
演示视频里那段32K,是把原始记录回放、再6倍快进的,片子里明确标了。这种地方不能含糊,不然看着像机器真的那么快。
六、没做成的那些,也记下来
吐字慢,是这台机器上最硬的墙——实测有效带宽约3.4GB/s,只有峰值的32%。我试了五条路,全失败:
| 试了什么 | 结果 |
|---|---|
| 线程加到5/6 | 掉69% |
| 关掉注意力优化 | −0.7%,等于没动 |
| 把缓存压成8位 | 31分钟没跑完,不是收益小,是跑不动 |
| 用小模型打草稿的投机解码 | −23% |
| 换更小的0.8B打草稿 | 4B上0%、2B上−41% |
最后一条的原因挺有意思:那个0.8B小模型自己吐字也只有5.2字/秒,体积小2.6倍却只快1.9倍,因为它同样卡在内存带宽上。「小模型先猜、大模型来验」这套的前提是小模型得快得多,这里根本不成立。
多轮对话的复用也没成。同一段前缀连发三次,每次都要26~27秒,日志里一句话说得很清楚:这个上下文不支持缓存复用。只有运行时在用户消息边界自动存的检查点能捡回来,30.4秒降到12.2秒,但那不是我优化出来的。
质量这块也没敢写「完全没影响」。困惑度差1.3%、误差重叠;90道题里官方对33、自产对34,配对检验p=1.0;长文里埋三个事实,5%和50%和95%的位置都能找出来3/3。这些只能支持一句很克制的话:没观察到差异,不能说「一模一样」。
七、录视频和收尾的杂事
最后要交一段演示视频,本以为半小时的事,结果又是一堆小坑。
这台机器跑的是Wayland,截图工具只支持ppm格式(png要2秒一帧、jpeg干脆没编进去),ppm约120毫秒一帧,于是按7帧/秒连拍一千多帧,再按脚本写下的毫秒时间戳剪、编码成30帧/秒。4B第一次录制直接被系统杀掉——没指定上下文长度,它按默认分配了7.19GB,机器总共7.8GB;改成2048之后峰值2.69GB,才录下来。
片头卡上标题被切了两个字,我一开始还被问「是不是故意不居中」。查下来是排版溢出:标题实测1810像素宽,左边界写死120,加起来1930,比1920的画布多10个像素。改成自动收字号、标题分两行,才算完。
配音更有意思。第一版男声太像播音,换了个年轻点的;然后开始逐个纠读音——「Qwen」被念成「库问」,得写成「通义千问」;「32K」念成「三二K」,得写「三十二K」;「2B」念成「二B」有谐音风险,改成「二十亿」;「Q4_0」会读成「Q4下划线0」,写成「Q4零」才对。我自己听不到合成结果,用的是个笨办法:同一句话换两种写法,时长完全一致就说明读音相同,比靠耳朵猜靠谱。最后还把整条音轨回读了一遍,逐句核对时间点有没有被截断。
还出过一次不大不小的丑:把自评表、答辩PPT这些内部材料传进了公开仓库。清理不只是删文件——历史提交里还留着,提交信息里也写过自评分。只好备份整仓,改写90多个提交再强推,第一遍还漏了一个 .bak 文件,全历史扫一遍又来第二次。内部材料从第一天就该进忽略列表,这条现在会条件反射了。
八、复盘
最值钱的不是「做了什么」,是「否掉了什么」。 片上内存、新版运行时、线程数,三条听起来都很像答案,每条都要花几个小时甚至一整天去证伪。三次否证之后,剩下的那个变量才可信。要是第一条就蒙对了,我大概反而说不清为什么快。
每个判断都得落到数字上,包括自己记的数字。 上面那些翻车,几乎全是「以为」和「实测」打架:温度节点其实是电池、权限没复原导致整机慢38%、SSH断了进程早死了、内存缓冲不是常数、按小模型外推大模型会低估。写「实测结论」前先看原始记录的采样窗口,这句话我大概会记很久。
「能跑」和「能用」中间隔着挺远。 32K能读完,但要等三个多小时;长问题首字62秒,咖啡凉了它还没开口。把边界老老实实写出来,比挑一个好看的数字更有用。
回头看,这半个月其实没做什么了不起的事:把一堆文件搬来搬去,在屏幕前等了很多次,然后为一个说不通的数字来回试,最后发现是之前记错了一个条件。但第一次亲眼看着一个模型从「打不开」到「能回话」,再到「回得快一点」,那种一点点把它摸清楚的感觉,还是挺值得记一下的。
下次再折腾别的,应该还是会从这一步开始:先让它跑起来,再慢慢问它为什么慢。