具身智能(怀客松)小记
 RX
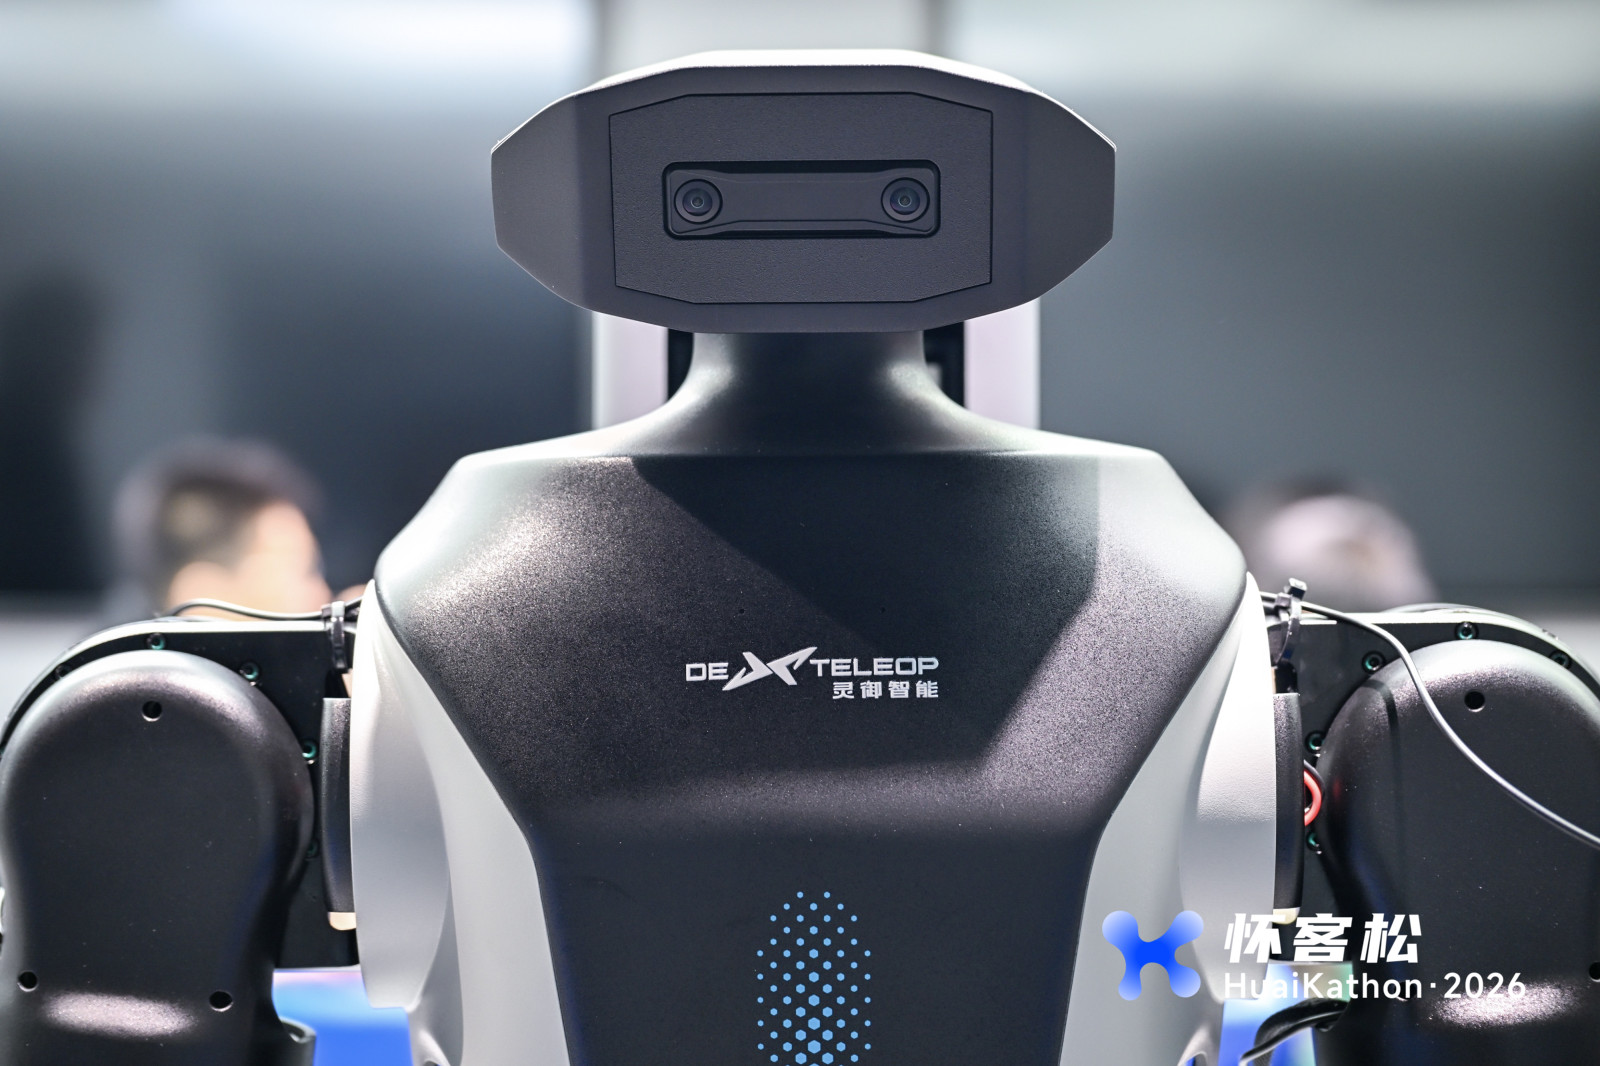
11 月 14 到 16 号,我们去北京怀柔科学城参加了一个具身智能的48h黑客松,这也算是第一次接触并亲身体验了具身智能。说是黑客松,但更像是一次命题的二次开发,使用的是灵御 TA2 的机器人。
其实本次黑客松主要也是抱着学习的态度来的,在现场也看到每个团队都有自己不同的方案,我们也还好,最后总是把全流程做出来了,对整体的流程也有了一个大概的了解。
最后交出去的东西不复杂:两个 VLA 模型管两条手臂,一个 bash 脚本管流程,一套自己写的轮式里程计管底盘。整条流程 10 步,跑一遍约 2 分 45 秒。
比完后我也是让ai总结了一下值得记录的一些点吧,也是很久没更新博客了。
一、第一天下午:先把题目摸清
题目叫「危境取物」:模拟危险品泄漏现场,要求是机器人从绿区出发,进红区把大约 7 cm 的沙包夹起来,回程在黄区停 10 到 15 秒模拟洗消,再到绿区放下。纯真机,没有仿真赛,算力是远端的A100和本地的Intel B70。
五道题是一条任务链,阶段闯关式累计计分:识别定位、自主导航避障、稳定抓取搬运、长程规划、人机交互与安全交付。100 分里赛题完成度占 60,技术方案 30,答辩 10。
看完手册我们做的第一件事不是写代码,是把 U 盘里的东西全过一遍:三套 Docker 镜像(数据转换、训练、部署)、部署说明、产品手册、Demo 代码。这一步花了两三个小时,但省掉了后面无数次的「这个参数到底什么意思」。
同一天还顺手解决了一个看起来无关的问题。 训练在云端上跑,而那个界面只能起一个 webui.cmd才能访问。队里想看进度都得启脚本,一开始每人自己起一个 webui.cmd,转发端口,谁关了谁就看不了。
最后的解法是在机器人那台B70(始终在线、同一网段)上拉一条 SSH 反向隧道,用 systemd 常驻:
[Service]
ExecStart=/usr/bin/ssh -i /etc/ta/team_key -p 20100 -N \
  -L 192.168.31.128:8081:127.0.0.1:8081 \
  -o ExitOnForwardFailure=yes -o ServerAliveInterval=30 \
  root@<训练平台>
Restart=always 这样全队只需要记住一个地址,谁都不用先起webui.cmd脚本才能查看训练进度。
再后面又使用隧道实现了远端访问(由于场馆晚上闭关6小时,但是我们的训练预计半夜就跑完了),也是怕没时间了只能多做一步隧道,使得在酒店即可访问。
二、第一天的决定:谁管什么
VLA 很诱人,恨不得从相机直接输出到轮子。但摆在我们面前的事实是:机器人能采到的数据只有手臂——16 维,左臂 7 + 左爪 1 + 右臂 7 + 右爪 1,底盘三个速度位是空的。这也是我们也是根据赛题以及时间综合考虑,觉得最快出demo且相对稳定的还是让VLA只管上半身,而底盘是直接写死。
所以分工是这样的:
| 任务 | 交给谁 | 理由 |
|---|---|---|
| 抓取、放置 | VLA | 要看图、要对位置变化泛化 |
| 底盘走多远、什么时候停 | 程序 | 训练数据里没有底盘;距离闭环比开环稳 |
| 黄区停 10–15 秒 | 程序 | 模型没有时钟,这是硬规则 |
| 流程顺序、失败处理 | 程序 | 一步错不能带着错状态往下走 |
后来问了主办方,回答是「只要做出来不限制方案」。这句话让我们更愿意尝试目前的方案了也是。
三、第一天晚上到第二天:数据、训练、部署
数据是遥操作采的,录成 rosbag2。手柄 X 开始、Y 结束切分 episode。
采之前我们先定了一件事:按阶段分两类数据,训两个模型,而不是混在一起训一个大模型。
| 数据集 | 任务描述 | 起点姿态 | 用途 |
|---|---|---|---|
| 抓取 | pick sandbag | pose_v3 | 抓取模型(端口 8000) |
| 放置 | place sandbag | pose_v5,86 条 episode 首帧均值 | 放置模型(端口 8001) |
两个 prompt 必须和部署时一字不差,否则模型不认。起点姿态也不是人手摆的,是拿该类数据第一帧的平均值算出来的——因为模型输出的是相对当前关节的增量,起点偏一点,后面全偏。
转换在 B70 上跑 Docker,用 VA-API 硬解,一条大约 35 秒,输出 LeRobot v2.1 格式,observation.state 和 action 都是 76 维。训练配置只取前 16 维,所以底盘那三个维度空着也不影响,不用重转。
训练用 π0.5 的 pi05_teleavatar_v2 配置,云端 WebUI 默认参数,两个任务各训一个 checkpoint。训完转成 PyTorch,部署到 B70 的 XPU 上,两个服务各占一张卡、约 7.8 GB 显存。
这一段基本是「按说明书执行」,唯一需要判断的是:要不要为了统一而牺牲精度。我们的选择是宁可两个模型、两套参数,也不把两个阶段混成一个。
四、第二天下午:底盘,从没有反馈到有反馈
TA2 的底盘 API 只给一个 [vx, vy, wz] 速度接口:不限速,也不反馈位移。也就是说,你告诉它「以 0.1 米每秒向右」,它不会告诉你走了多远。
第一次实测就发现不对劲:指令 0.10 m/s 跑 8 秒,卷尺量出来只有 45 到 50 厘米,而按指令算应该是 80 厘米。换算下来,实际速度大约是指令的一半,四档速度测出来比值稳定在 0.509 到 0.523。这意味着「按时间开环」根本不可行——同样的指令时间,误差能到一倍。
所以只能自己做里程计。好在 /chassis/joint_states 里三个轮角关节是按 200 Hz 发的,我们统计了 771 条消息,间隔 4.5 到 5.6 ms,没有一次超过 50 ms 的断档。三轮全向的运动学不复杂:
x(右) = R · (2·d3 − d1 − d2) / 3
y(前) = R · (d1 − d2) / √3
转角 = R · (d1 + d2 + d3) / (3·L) R = 5.2 cm,L = 15 cm麻烦的是每个轮角读数有 8π 的回绕。连续记录里看到 chassis_joint1 在某一刻一步跳了 +25.1285 rad,正好是 8π。所以累加时不能直接做差,得逐样本判断:相邻两点差超过 4π 就当作回绕,加或减 8π。200 Hz 下真实的单步变化不到 0.02 rad,所以不会误判。
接下来是两个小时的标定,四件事:
- 方向:+vx 向右,+vy 向前(头部相机朝向),+wz 逆时针。
- 比例:指令与实际位移的换算系数。
- 回绕:每个轮角读数有 8π 的回绕。记录里看到某个轮子一步跳了 +25.1285 rad,正好是 8π。所以累加不能直接做差,得逐样本判断,差超过 4π 就当回绕处理。
- 验证:后退 8 秒,里程计 46.8 cm,卷尺 45–50 cm;横移累计 72 cm,卷尺 72 cm;原地转 3 秒,里程计 28.7°,目测 28–30°。
标定完,写了一个 drive.py:给一个距离,它自己加速、巡航、离目标 8 cm 开始线性减速,到点发零速度。同时加了五道保险——轮角数据断流就停、另一个轴漂移超过 8 cm 就停、超时就停、行程超过目标 1.3 倍就停、NaN 一律当零速度。
这里定了一条后来一直没破的规矩:一次只让一个轴动,不斜着走。 斜向的里程计没验证过,宁可多走一段直线。
五、第二天晚上:把动作串成一条线
有了能走准的底盘和两个模型,接下来是把它们串起来。
路线是现场量的。红绿各约 2 米见方,中间靠后是 1 米见方的黄区。从绿区出发到红桌正好 140 cm 横移加 22 cm 前移,回程反过来。这些数字没法从手册推,只能拿着卷尺在场地上量,量完写死进脚本。
十步是这么排出来的:
| 步 | 动作 | 关键参数 |
|---|---|---|
| 0 | 手势启动 | 头部相机,五指张开,实测 1.84 秒触发 |
| 1 | 抬到抓取起点 | 14 个关节读到位就停,容差 0.08 rad |
| 2 | 张开双爪 | 一次性 |
| 3 | 到红桌 | 左 140 cm,前 22 cm |
| 4 | 抓取推理 | 端口 8000,22 Hz,horizon 16,20 秒 |
| 5 | 检查推理进程与夹爪 | 读一次右爪,确认夹住 |
| 6 | 复位到放置起点 | 右爪保持夹持,全程不碰 |
| 7 | 回程 | 后 22,右 70,停 12 秒,右 70,前 20 |
| 8 | 左手夹一下 | 提示旁人「要放了」,右爪不碰 |
| 9 | 放置推理 | 端口 8001,20 Hz,horizon 10,30 秒 |
| 10 | 后撤 | 22 cm |
写这个 bash 脚本时,花时间最多的不是动作,是失败的处理:任何一步失败就打印 STOP at step ... 并停住,后面全不执行,同时告诉使用者「机器人不在计划位置,重跑前先手动确认」。底盘一段没到位就停整条,因为带着错误位置继续走一定会撞桌子。
黄区那一停取 12 秒。规则要求 10 到 15,取正中是为了给裁判计时留余量;程序里还做了范围校验,传 8 秒或 20 秒直接拒绝启动。
放置段有个特殊情况:训练数据里左臂没有跟随动作,所以模型输出的左臂目标是假的。处理方式是三层保护——客户端补丁把左臂 7 个目标替换成起点值;放置期间后台以 20 Hz 持续发同样的 7 个数;放置前先读一次左臂,差超过 0.08 rad 就不开始。放置前后各读一次,位移超过 0.05 rad 就打感叹号。
「冻结」这件事必须能被观察到,不能只相信代码。
六、第三天:联调
第三天几乎全在联调。方法很土,但有效:先用 FROM= 分段跑,一段一段接。
FROM=v5      只跑第 6 步(复位)
FROM=leftack 只跑第 8 步(左手提示)
FROM=place   只跑第 9 步(放置推理)
每段单独验过,再接两段,再接三段。中间还做了个 DRY=1 模式,只检查不动机器人:容器在不在、8000 和 8001 有没有监听、轮角有没有数据、有没有别的控制程序在跑。这个模式省了很多次「跑起来发现端口没起」的往返。
也是在这一天,四个坑依次冒出来,每一件都先被我们误判过一次:
| 现象 | 一开始以为 | 实际是 |
|---|---|---|
| 比完手势,爪子没夹 | 命令没发出去 | 闭 0.5 秒又张开 1 秒,净效果就是「回到张开」,结尾状态才是你看到的 |
| 抓取跑一半,三路相机同时过期 | 网络不稳 | 接收端缓冲被内核卡在 208 KiB(申请的是 20 MB),启动那 1 秒涌进 3 MB 直接溢出 |
| 每次抬臂都报「关节没到位」 | 机械卡阻 | 判定循环用 timeout 1 读手臂,而 ros2 启动要 0.82 秒,每轮都读到空;实际最大差 0.0097,容差 0.08 |
| 轮子 15 秒一步不动 | 桥断了 / 网络丢包 | /kinco/motor_state: NOT_READY_TO_SWITCH_ON,伺服主回路没电,功率级根本没上电 |
最后一条最要命,也最不像代码问题。当时看到的是:速度指令有人订阅、桥确认了、轮角数据 200 Hz 在发,就是里程计一动不动。查桥日志还发现机器人的 chassis_driver 节点在反复起停,每 6 到 29 秒一次,看上去特别像网络。
直到读到一个状态字:NOT_READY_TO_SWITCH_ON——CiA 402 伺服状态机的最底端,主回路没电或者有故障没复位。这个状态下驱动器连「使能」都接受不了。解法不在终端里,在物理世界:急停按钮、充电线、底盘总开关。
前面三个也一样,都不是「参数没调对」,而是测量本身在骗人:夹爪的结束状态、socket 的内核上限、timeout 比程序启动还短。
七、结果
第三天大概上午,整条流程第一次连续跑通。2 分 45 秒左右。
那天我们没欢呼。因为前面被「看起来通了」骗过太多次——单段能跑、两段能跑,一接起来就断。直到连跑三遍,每遍时间都在 2 分 45 秒上下,才敢确认这是稳的。
时间账大概是:手势等待不算,抬臂 5 秒、走到红桌 24 秒、抓取 20 秒、复位 9 秒、回程 43 秒(含黄区 12 秒)、放置 30 秒、后撤 4 秒。
八、复盘
项目里最贵的是「失败之后什么都不做」的那部分代码。 底盘一段没到位就停整条、视频过期就停机、姿态差超过容差就不启动、夹爪位移超过 0.05 rad 就打感叹号。这些代码不产生任何动作,但每一次都避免了一次撞桌子或者掉包。
每个判断都要落到数字上。 上面四个误判,全都是「以为」和「实测」打架。赢的永远是实测:卷尺、rtp_seq_gaps、关节读数、状态字。
慢一点比快一点难。 我们最后把放置推理从 10 Hz 提到 20 Hz,关节增量的执行速率正好翻倍。这不是「一点点提速」,手臂直接快了一倍。判断它行不行,只有一条:看那 20 多秒里机械臂是不是平顺地走到沙包上方再落下。
三天里写得最久的一行代码不是推理,是 set -e 加上一堆 || die。但正是这些「不做事」的分支,让一个会撒谎的系统变得可以说实话:夹爪会装夹、视频会装作在流、手臂会装作到了、驱动器会装作收到了指令。每拆穿一个,流程就稳一分。